Acesso declarado e acesso efetivo à IA: porque o robots.txt não chega
Uma regra robots.txt é uma preferência pública, não um caminho de rede garantido. Um bot permitido pode receber 403, um desafio ou um timeout de um CDN, WAF ou servidor.
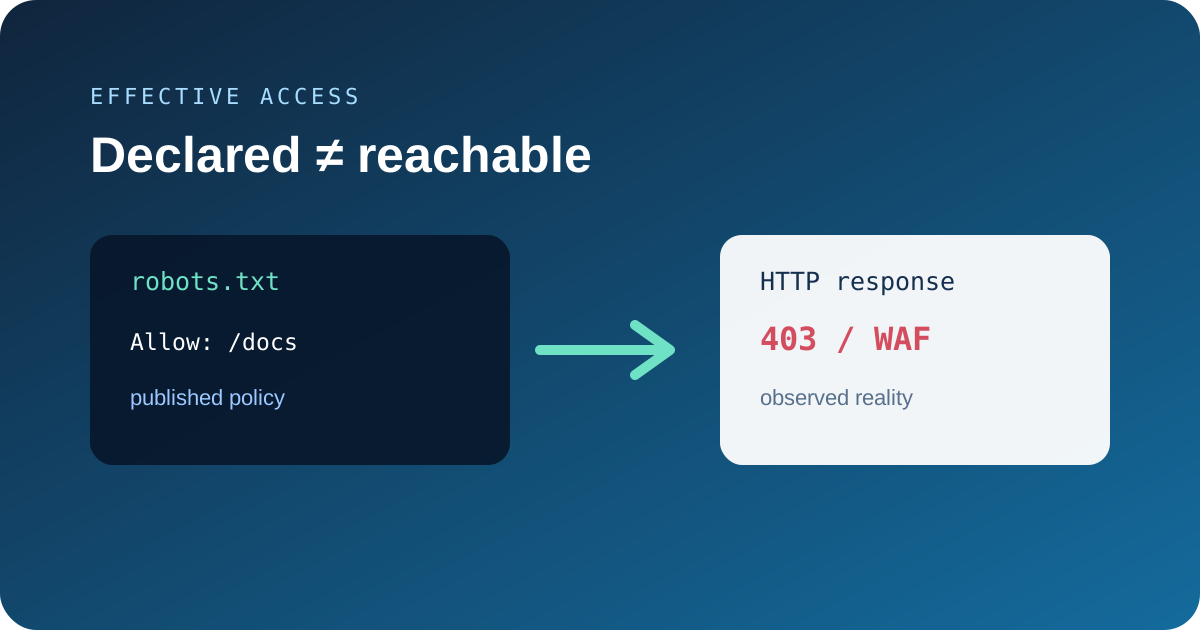
O acesso declarado é a regra visível; o acesso efetivo é a resposta obtida numa URL pública representativa.
Qual é a diferença?
O acesso declarado é a regra visível; o acesso efetivo é a resposta obtida numa URL pública representativa.
Separe estes sinais. Obtenha o robots.txt em produção e registe códigos, redirecionamentos, tipo de conteúdo e cabeçalhos. Allow não prova uma recolha bem-sucedida.
Como testar com responsabilidade?
Use poucas URLs públicas, respeite limites e compare com registos do servidor ou da segurança.
Um 403, desafio JavaScript ou timeout deve ser descrito como problema técnico, não como prova de que o bot ignorou o robots.txt.
O que publicar?
Indique a data, a classe de URL, a categoria de resposta e as limitações do teste.
Assim, o resultado ajuda as equipas sem alegar que reproduz todas as redes de bots ou sinais privados de classificação.
Checklist prático
Estes passos transformam o princípio do artigo num hábito editorial e de medição reproduzível.
- Registe o URL exato, o token e a data antes de alterar uma regra.
- Separe a diretiva publicada, a resposta HTTP observada e a visibilidade na pesquisa.
- Ligue à documentação oficial e explique o que o teste não pode provar.
Perguntas frequentes
Allow garante o rastreamento?
Não. Apenas indica que a regra publicada não proíbe o caminho.
Devo começar por bloquear IPs?
Não. Comece pela política documentada e pelo controlo de acesso; os IPs mudam.