Acceso declarado y acceso real de la IA: por qué robots.txt no basta
Una regla de robots.txt expresa una preferencia pública, no garantiza el camino de red. Un bot puede estar permitido y recibir un 403, un desafío o un tiempo de espera.
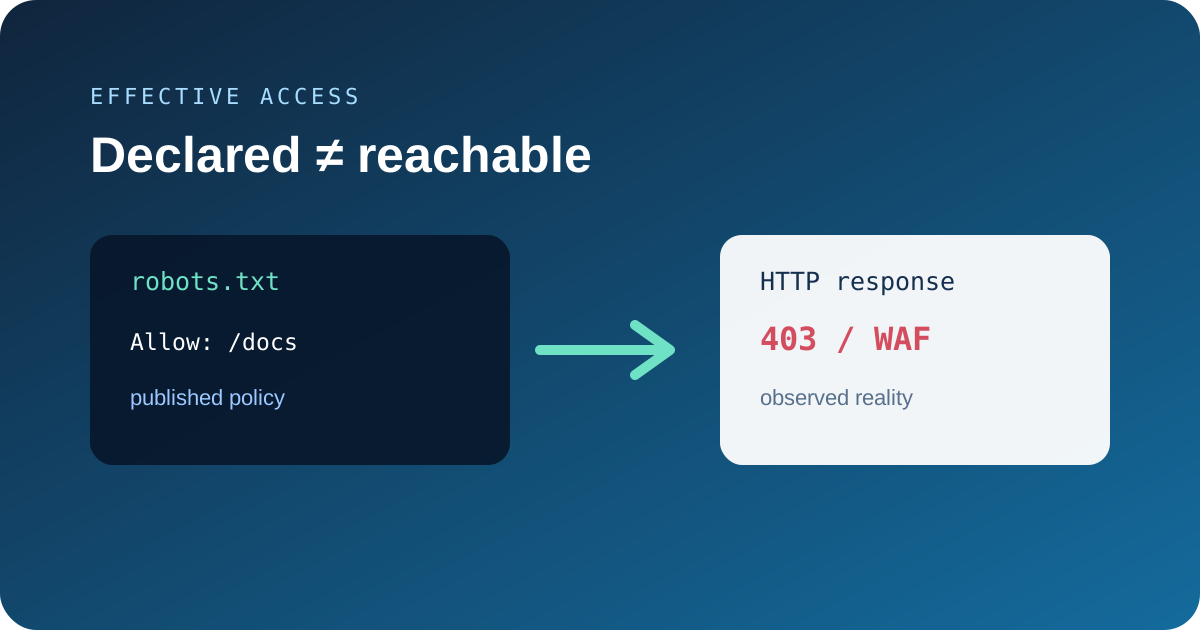
El acceso declarado es la regla visible; el acceso real es la respuesta que recibe una URL pública representativa.
¿Cuál es la diferencia?
El acceso declarado es la regla visible; el acceso real es la respuesta que recibe una URL pública representativa.
Separa ambos datos. Obtén el robots.txt en producción y registra códigos, redirecciones, tipo de contenido y cabeceras. Allow no demuestra una descarga correcta.
¿Cómo probarlo?
Usa pocas URL públicas, respeta límites y contrasta con logs del servidor o la seguridad.
Un 403, un desafío JavaScript o un timeout es un problema técnico de disponibilidad, no una prueba de que el bot ignoró robots.txt.
¿Qué publicar?
Publica fecha, clase de URL, categoría de respuesta y limitaciones.
Así el resultado es útil sin afirmar que reproduce todas las redes de bots o señales privadas de ranking.
Lista práctica
Estas etapas convierten el principio del artículo en un hábito editorial y de medición reproducible.
- Registra la URL exacta, el token y la fecha antes de cambiar una regla.
- Separa la directiva publicada, la respuesta HTTP observada y la visibilidad en búsqueda.
- Enlaza la documentación oficial y explica qué no puede demostrar la prueba.
Preguntas frecuentes
¿Allow garantiza el rastreo?
No; solo indica que la regla publicada no prohíbe esa ruta.
¿Debo bloquear IP primero?
No. Empieza por política documentada y autenticación; las IP pueden cambiar.