Accès IA déclaré ou réel : pourquoi robots.txt ne suffit pas
Une règle robots.txt exprime une préférence publique, pas un chemin réseau garanti. Un robot peut être autorisé sur le papier et recevoir malgré tout un 403, un challenge ou un délai d’attente.
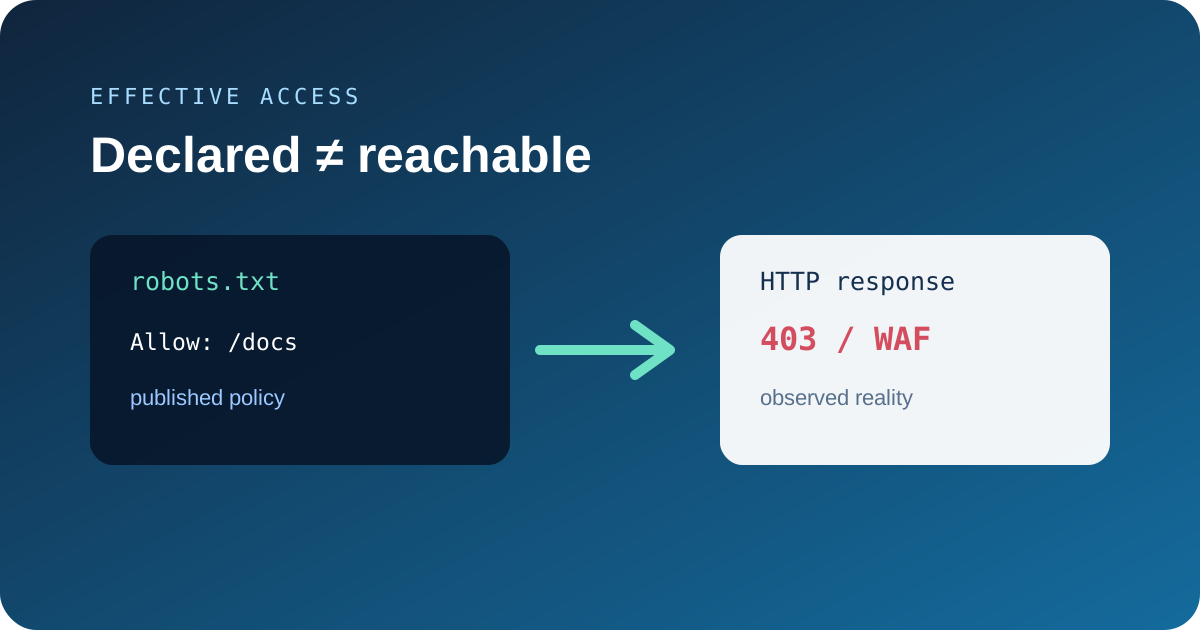
L’accès déclaré est la règle visible dans robots.txt ; l’accès réel est la réponse reçue sur des URL publiques représentatives.
Quelle est la différence ?
L’accès déclaré est la règle visible dans robots.txt ; l’accès réel est la réponse reçue sur des URL publiques représentatives.
Séparez ces signaux dans l’audit. Récupérez le fichier en production puis notez les codes, redirections, types de contenu et en-têtes de blocage. Une règle Allow ne prouve pas une récupération réussie.
Comment tester proprement ?
Utilisez peu d’URL publiques, respectez les limites et comparez avec les journaux du serveur ou de la sécurité.
Un 403, un challenge JavaScript ou un timeout doit être décrit comme un problème de disponibilité technique, pas comme une violation de robots.txt.
Que publier ?
Publiez la date, la classe d’URL, la catégorie de réponse et les limites du test.
Cette transparence aide les équipes sans prétendre reproduire tous les réseaux de robots ni les signaux de classement privés.
Checklist pratique
Ces étapes transforment le principe de l’article en une habitude éditoriale et de mesure reproductible.
- Notez l’URL, le token du robot et la date avant de modifier une règle.
- Séparez la directive publiée, la réponse HTTP observée et la visibilité en recherche.
- Liez la documentation officielle et précisez ce que le test ne peut pas prouver.
Questions fréquentes
Allow garantit-il le crawl ?
Non. Il indique seulement que la règle publiée n’interdit pas le chemin.
Faut-il commencer par bloquer les IP ?
Non. Commencez par la politique documentée et l’authentification ; les IP peuvent changer.